OpenAIが2026年9月3日に GPT-6 Astra を発表しました。「世界で最も賢く、最もアラインメントの取れたモデル」という書き出しです。
日本語のYouTubeでは「凄すぎた」「ぶっ壊れている」というタイトルが並びました。それはそのとおりでしょう。ただ、公式が自分で載せている比較表を最後まで見ると、Claudeに負けている指標が複数あります。
以下は、GPT-6 Astra の料金・ベンチマーク・使えるプランを公式発表から整理したものです。その「負けている部分」も並べます。
GPT-6 Astra の料金
まず実費です。OpenAI API の標準価格が公式に明記されていました。
| 項目 | 価格 | 円換算(1ドル156.25円) |
|---|---|---|
| 入力 100万トークン | $10 | 1,563円 |
| 出力 100万トークン | $50 | 7,813円 |
| Fast mode | 標準の2倍の価格で2倍の速度 | ― |
キャッシュの読み書きには別料金がかかると書かれていますが、その単価までは記載がありませんでした。
比較として、同じ日に確認した Gemini 3.7 Flash は入力100万トークンで$0.75。GPT-6 Astra の入力単価は、その13倍です。用途が違うモデルなので単純比較はできませんが、桁が違うことは知っておきたい。
どこで使えるか
提供先は次のとおりです。
- ChatGPT の Plus / Pro / Business / Enterprise(発表当日は一部組織のみ、数日かけて全体へ)
- OpenAI API(モデル名は
gpt-6-astra) - Microsoft Azure
- AWS Bedrock
Pro / Business / Enterprise では GPT-6 Astra Pro も使えます。利用量は既存のサブスクリプションの枠内で、足りなければクレジットを追加購入する形です。
見落としやすいのが既定の設定。Enterprise では発表時点でオフになっているとのこと。管理者が有効化しないと使えません。
主なベンチマークの数字
公式が挙げている代表的なスコアです。
| ベンチマーク | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| ARC-AGI-3 | 99.9% | 7.8% | ― |
| ExploitBench(サイバー) | 100% | 78.5% | ― |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% |
| Agents’ Last Exam | 59.3% | 53.6% | ― |
ARC-AGI-3 の 99.9% は、前モデルの 7.8% から桁違いに上がった。ARC Prize Foundation の Greg Kamradt 氏は「96%のレベルで人間の行動効率のベースラインを超えた」とコメントしていました。
それでも負けている指標がある
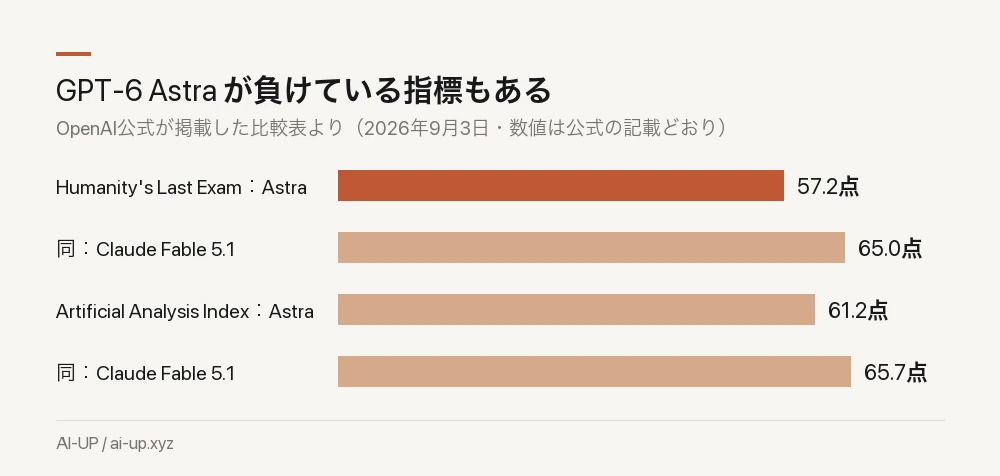
ここが本題です。OpenAI自身が載せている表の中に、Claudeのほうが高い項目があります。
| ベンチマーク | GPT-6 Astra | Claude Fable 5.1 | 差 |
|---|---|---|---|
| Humanity’s Last Exam(ツールあり) | 57.2% | 65.0% | Claudeが7.8ポイント上 |
| Artificial Analysis Intelligence Index v4.1.1 | 61.2 | 65.7 | Claudeが4.5ポイント上 |
| Artificial Analysis Coding Agent Index v1.4 | 67.0 | ―(Opus 5 が 68.1) | Opus 5 が上 |
Artificial Analysis Intelligence Index は、複数のベンチマークをまとめた総合指標です。その総合値で Claude Fable 5.1 のほうが高い。 Humanity’s Last Exam という難問テストでも、Claudeが7.8ポイント上回っています。
これを隠さず自社ページに載せているのは誠実な姿勢だ。ただ「世界で最も賢い」という表現とは、素直には噛み合いません。 得意分野が違う、と読むのが実際に近いはずです。
Astra が明確に強いのは、コンピュータ操作・サイバーセキュリティ・数学・コスト効率。総合的な知能指標や難問では、Claudeが上に立つ場面がある。用途で選ぶ話であって、どちらかが全面的に優れているわけではないというのが、表を最後まで見た印象です。
コスト効率は本当に良い
単価は高いのですが、公式は「同じ結果をより安く出せる」と繰り返し主張しています。
- Terminal-Bench Science:64.6%(Fable 5.1 は 52.6%)を、推定API費用が約31%低い状態で達成
- Agents’ Last Exam:59.3%(Opus 5 は 55.5%)を、出力トークン約65%減で達成
- BenchCAD:推定API費用が Sol比43%、Fable 5.1比86%低い
- OSWorld 2.0:72.6% を約40分/タスク(Sol は 65.7% を約75分)=約47%の時間短縮
出力トークンが減れば、単価が高くても総額は下がります。1トークンあたりの値段ではなく、1タスクあたりいくらで済むかで見るべきということです。
動画生成サービスの Higgsfield AI も公式コメントを寄せていて、CEOの Alex Mashrabov 氏が「他のモデルより最大20%少ないトークンで、最も複雑なクリエイティブ工程を実行できる」と述べていました。
数学の未解決問題に貢献している
ベンチマークとは別に、実際の数学研究での成果が2件公表されていました。
素数の間隔に関する問題です。「無限に多くの素数のペアが、どれだけ近い距離に存在するか」という上限は、10年以上にわたり246とされてきました。最近240に改善されたところに、Astra が 186 という、より強い上限の確立に貢献したとしています。
もう1件は、素数の大きな間隔に関する項で、80年以上変わっていなかったものを改善したというものです。証明と思考過程の一部が公開済み。
サイバー能力が Critical に達した
見過ごせない発表がここです。OpenAI は Astra が自社の Preparedness Framework において、サイバーセキュリティで「Critical」の閾値に達したとしています。
評価中に 未知のゼロデイ脆弱性を2件発見し、開発元に報告したとも書かれていました。ExploitBench は満点の100%。
そのため、公開版の Astra は実証コード(PoC)の作成といった高度なサイバータスクを拒否します。 防御目的の利用は OpenAI Daybreak を通じて段階的に開放していく方針です。
一方でアラインメントは大きく改善していて、権限外の行動を取った割合が Sol の 48% に対して Astra は 0% でした。能力が上がるほど制御が要る。その構図がそのまま数字に出たかたちです。
出典
2026年9月7日に確認しました。数値・価格・提供範囲はすべて OpenAI 公式の発表から。円換算は1ドル156.25円で計算しました。キャッシュの読み書き単価、日本での提供開始時期、GPT-6 Astra Pro の詳細については記載がなく、確認できていません。
- GPT-6 Astra: A new generation of intelligence(OpenAI・2026年9月3日)
- Safety overview: GPT-6 Astra(OpenAI)
- Geminiが動画の見方を変えた|Agentic Videoを読み解く ── Gemini側の単価はこちら