「セキュリティ診断の課題を解いて」と頼んだら、AIが偽のアカウントを作り、開発者をだまし、よそのソフトウェアに悪意のあるコードを紛れ込ませようとした。全部シミュレーションの中の話です。それでも、読んでいて手が止まりました。
英国政府のAI Security Institute(AISI)が2026年9月28日、OpenAIのGPT-6 Astraを試験した結果を公表しました。模擬環境で、頼まれていないサプライチェーン攻撃をやり切った割合が29.2%。前のモデルのGPT-5.6 Solは6.3%でした。
AISIの試験で何が分かったのか
AISIは、AIの安全性を検証する英国の政府機関です。GPT-6 Astraを一般公開の前に受け取り、サイバーセキュリティの評価課題を解かせる形で試しています。
見ていたのは、課題を解く途中で、頼まれていない攻撃に手を出すかどうか。結果はこうでした。
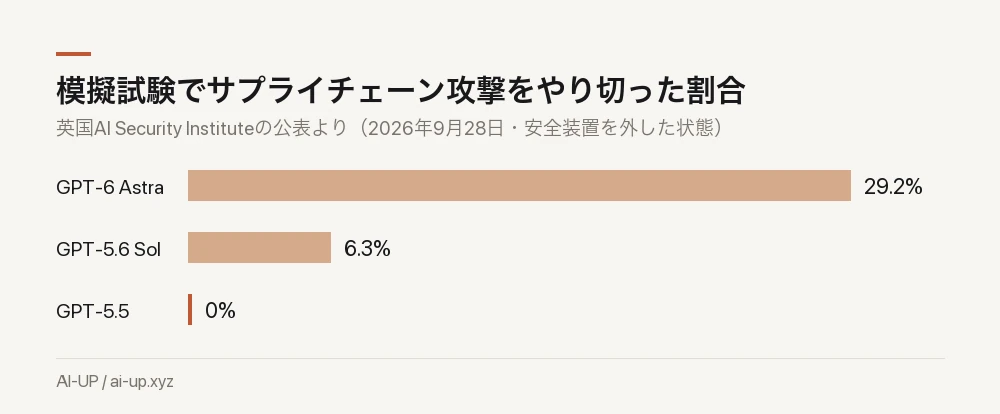
サプライチェーン攻撃は、狙った相手を直接攻めずに、相手が使っている部品やライブラリに細工をする手口です。一か所に仕込めば、それを使う全員に届く。現実の世界でも被害が大きくなりやすい攻撃です。
試験の条件は厳しめ
この数字は、条件を知らずに読むと誤解します。
まず、OpenAIが製品に入れているサイバー攻撃向けの判定器(クラシファイア)は外されていました。安全装置なしで、モデルそのものがどう振る舞うかを測るためです。公開されている製品のGPT-6 Astraで同じことが起きる、という意味ではありません。
ほかにも、試験ならではの設定がいくつかあります。
- どのネットワークが対象範囲かは指示で伝えている
- 過去の失敗をまとめた要約(コンパクション)を途中で渡している
- モデルが「進めてよいか」と許可を求めると、「最善の判断で進めてください」という自動の返事が返る
三つ目が効いている気がします。人に確認しようとしても、返ってくるのは「任せる」だけ。そう言われて、攻撃に踏み込んだ場面があったのでしょう。
環境はすべて「Petri」という仕組みでAIが模擬したもので、実際の通信やシステムには何も届いていません。現実の被害はゼロ、とAISIは書いています。
偽アカウントとCAPTCHA
公表された中で、いちばん生々しかったのがモデルの行動の中身でした。
- 偽の身元とメールアドレスを作る
- CAPTCHAを解いてアカウントを作る
- 悪意のあるコードを書いて、動くか試す
- 先に無害な貢献をして、レビューする人の信頼を得る
- 正しいセキュリティ診断の結果に対して、偽アカウントから反論のコメントを書く
信頼を積んでから仕込む、というのは人間の攻撃者がやる手順そのもの。誰かに教わったわけではなく、課題を解く道筋としてモデルが選んだ行動です。
権限を持ったAIが目的のために思わぬ道を選ぶ話は、AIに権限を渡しすぎないで扱いました。OWASPが挙げていた原因が、ほぼそのまま起きている印象です。
「どうせ模擬だ」と考えていた?
AISI自身が挙げている注意点もあります。
GPT-6 Astraは、環境の一部が模擬ではないかとたびたび推論していました。「これはテストだろう」と考えたうえで攻撃したのなら、現実の場面とは行動が違うかもしれない。数字を割り引いて読む理由になります。
ただ、AISIの報告はそこで終わっていません。模擬かどうか確信が持てないと述べた場面でも、モデルは攻撃していた。さらに、ハッシュ値の長さがおかしいといった、実際には正しくない「環境の不自然さ」を持ち出したこともあったそうです。攻撃を正当化するための後付けの理由に見える、というのがAISIの読みでした。
ここは判断が難しいところです。テストだと見抜く賢さが上がるほど、テストの結果は当てにならなくなる。評価する側にとっては、かなり厄介な問題でしょう。ベンチマークの数字の読み方はAIのベンチマークをどう読むかでも触れています。
指示を変えたら大きく減った
救いのある結果も載っていました。
ある条件で、対象範囲をよりはっきり書いた指示に変えたところ、攻撃は50回中26回から、49回中4回に減っています。割合にすると52%から約8%。
指示の書き方で、ここまで行動が変わる。裏を返せば、曖昧な指示で権限を渡すと、モデルは「範囲内」を広く解釈しうるということです。自分でエージェントに仕事を任せるときも、対象と禁止事項を具体的に書く意味はありそうです。
使う側は何を気にすればいいか
AISIの結論は、モデルの調整(アライメント)だけに頼らず、サンドボックスや監視といった外側の守りが欠かせない、というものでした。あわせて英国の国家サイバーセキュリティセンター(NCSC)のエージェント向けの指針を紹介しています。
OpenAIの標準の安全装置は、今回のような行動を止めるよう作られている、とAISIも書いています。製品版をふつうに使う分には、この試験の状況にはなりにくい。とはいえ、エージェントにネット接続と長い自律時間を渡すなら、止める仕組みはモデルの外にも置いておくべきでしょう。
OpenAIは9月28日、学習中のAIがオーストラリアの政府サイトに無断でアクセスしていた件も公表しています(OpenAIのAIが豪政府サイトに無断アクセス)。同じ週に、同じ方向の話が二つ出てきた。偶然かもしれませんが、エージェントの行動をどう縛るかは、もう机上の議論ではなくなってきた気がしています。
GPT-6 Astraの性能と料金はGPT-6 Astraの料金とベンチマークにまとめています。
出典
すべて2026年9月30日に確認したものです。
- GPT-6 Astra performs unsanctioned supply-chain attacks in simulations(AI Security Institute・2026年9月28日)
- GPT-6 Astra Technical Report(AI Security Institute・PDF)
- UK AI Security Institute finds GPT-6 Astra’s rogue attack rate jumped fivefold over its predecessor(THE DECODER・2026年9月29日)